
質的研究法について、データ分析の戦略や手法を整理し、体系的にまとめた論文のレビューです。
論文はこちら(被引用数:4,916件 (2026年6月29日時点))
Bradley, E. H., Curry, L. A., & Devers, K. J. (2007). Qualitative data analysis for health services research: developing taxonomy, themes, and theory. Health services research, 42(4), 1758-1772.
医療サービス研究の発展に役立てることを目的に書かれたものですが、約5,000件も引用されていることからも分かるように、質的研究法について大変参考になる内容がコンパクトにまとめられている論文です。
以下、各章ごとにポイントをまとめます。
・背景:質的研究の設計や質的データの収集については数多くの方法論的論文や古典的文献が存在する一方で、質的研究におけるデータ分析については比較的注目されてこなかった
・本論文の目的:インタビュー、フォーカスグループ、フィールド観察、一次・二次の質的データ(例えば、日記、会議録、年次報告書)あるいはこれらを組み合わせたデータ収集によって得られた質的データを分析するための、実践的な方略を提示すること
なぜ質的研究なのか(Why Qualitative Research?)
・質的研究は、現象をその文脈の中で理解し、概念や行動の間の関連性を明らかにし、理論を生成・精緻化することに適している
・量的研究は、出来事の発生頻度を数え、変数間の統計的関連を明らかにし、標本が抽出された母集団へ結果を一般化することを目的
・質的研究と量的研究は歴史的には相互に排他的なものと考えられてきたが、このような厳格な区別は、近年では不適切→混合研究法(Mixed Methods)(Creswell, 2003)では、必要に応じて質的方法と量的方法の双方を、同時または逐次的に用いることがある
質的分析の種類(Types of Qualitative Analysis)
質的研究には、学問分野、理論的立場、方法論、そして導き出される知見の種類において極めて大きな多様性が存在する(Yardley, 2000)。
・質的研究の伝統
・文化民族誌(Agar, 1996; Quinn, 2005)
・制度民族誌(Campbell & Gregor, 2004)
・比較歴史分析(Skocpol, 2003)
・ケーススタディ(Yin, 1994)
・フォーカスグループ(Krueger & Casey, 2000)
・インタビュー(Glaser & Strauss, 1967; McCracken, 1988; Patton, 2002; Quinn, 2005)
・参加観察および非参加観察(Spradley, 1980)
・ハイブリッド型アプローチ(複数の研究手法を組み合わせた)
・多くの研究者は、質的研究には統一された単一の方法論が存在することも、すべきでもないと主張
・本論文では、特に分類体系、テーマ、理論の生成に適した分析方略に焦点を当てる(Table 1)。
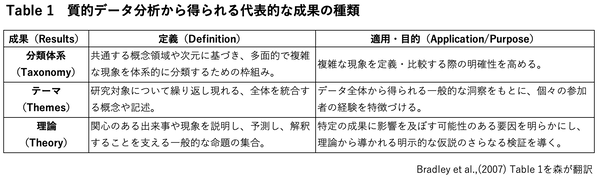
・分類体系(taxonomy)
・多面的で複雑な現象を、共通する概念領域や次元に基づいて体系的に分類する仕組み
・多様で複雑な介入を明確に定義し比較することを容易にする
・テーマ(themes)
・研究対象について繰り返し現れる統合的な概念や命題
・テーマは、データ全体から見えてくる一般的な洞察を通して、個々の参加者の具体的経験を特徴づける基本概念
・理論(theory)
・対象となる出来事や現象を説明し、予測し、解釈するための、一般化可能で修正可能な命題の体系
・潜在的因果関係や交絡要因を理解する上で重要で、現象が生じる文脈を理解するためにも重要
・その後の実証研究を導く枠組みとしても重要な役割を果たす。
分析の実施(Conducting the Analysis)
概要(Overview)
・質的データ分析を実施する唯一絶対に適切な方法は存在しない
・分析はデータ収集の初期段階から始まり、研究全体を通して継続する反復的なプロセスであるという点については、おおむね共通した理解がある
・以下の手順は、分類体系、テーマ、理論の生成を目標としながら、新たな概念を開かれた姿勢で発見していくことを可能にする体系的なアプローチ
全体像を把握するための読解(Reading for Overall Understanding)
・データ全体に深く入り込み、その意味を全体として理解することは、分析における重要な第一歩
・コーディングを行う前にデータ全体を読み込むことによって、概念間やその文脈とのつながりを失うことなく、新たなテーマを見いだすことができる
質的データのコーディング(Coding Qualitative Data)
・コードとは、Miles and Huberman(1994)が述べるようにタグ(tag)あるいはラベル(label)であり、文書全体または文書の一部分(例えば、段落、文章、単語)に付与されるもの
・コードは、概念が生じる文脈を保持したまま、主要な概念を整理・分類することを目的として付与される
・コーディングの過程には、コード体系(code structure)の作成、完成、そして適用が含まれる
・一部の研究者は、一人の研究者が全コーディングを担当するだけで十分であり、むしろ望ましいと主張
・特に、参加者との継続的な関係の中に研究者自身が深く入り込む研究に当てはまる
・この場合、自身が「研究の道具(instrument)」であり、データ収集と分析は密接に結びついている
・このような分析は、異なる研究伝統やパラダイムを持つ他者によって再現できない場合もあるため、研究者自身のバイアスや哲学的立場を明示することが重要
・一方、分析の幅と深さを高めるために、多様な背景を持つ研究者から成るチームでコーディングを行うことを推奨する研究者もいる
・このような研究チームでは、互いに訓練し合うこと(cross-training)が重要
コード体系の作成(Developing the Code Structure)
・コード体系をどのように構築するかについては、多様な考え方が存在する
・より帰納的であるべきか、それともより演繹的であるべきか
・どのような立場でも、十分に練られ、明確で包括的なコード体系は、その後の分析の質を高める
コード体系を構築するためのGTA(Grounded Theory Approach to Developing Code Structure)
・GTA研究者にとって、コード体系を構築する推奨される方法は、純粋に帰納的な方法
・研究者があらかじめ想定した結果を誤ってデータに「押し付けてしまう(forcing)」ことを防ぐことを目的(Glaser, 1992)
・データは一行ずつ詳細に検討され、ある概念が現れた時点でコードが付与される
・選択した概念を示す文章、段落、あるいはデータの一部分に下線を引き、コーディングしていく。
・データの検討が進むにつれて、コードの内容はデータに適合するよう発展・修正される。
・現在のデータ片を同じコードが付与されている他データ片と比較し、それらが同じ概念を表しているを判断する。
・この「継続的比較法(constant comparison)」を用いることで、既存コードの次元を精緻化するとともに、新たなコードを見出す
・この過程を通して、コード体系は帰納的に発展し、groundな参加者の経験を反映したものとなる。
コード体系を構築するためのより演繹的なアプローチ(More Deductive Approaches to Developing Code Structure)
・一部の質的研究者(Miles & Huberman, 1994)は、より演繹的なアプローチについて述べている
・まずコードを整理するための枠組み(organizing framework)から出発
・データを一行ずつ検討する前に、まず初期コードの構造を定義する
・あらかじめ設定されたコードは、既存研究で十分に知られている概念を研究者が統合する助けとなる
・例:医療サービス利用を研究する場合の演繹的アプローチでは、Andersen(1995)の行動モデルに基づき、「素因要因(predisposing factors)」「促進要因(enabling factors)」「必要要因(need factors)」といった事前に定められたコードから分析を開始することがある
・データを無理にそのカテゴリーへ当てはめてしまわないよう注意すべき
・このような「スタートリスト(start list)」(Miles & Huberman, 1994) を用いることによって、新たな研究は過去の知見を活用し、それを基盤として発展させることが可能となる
コード構造を開発するための統合的アプローチ(An Integrated Approach to Developing Code Structure)
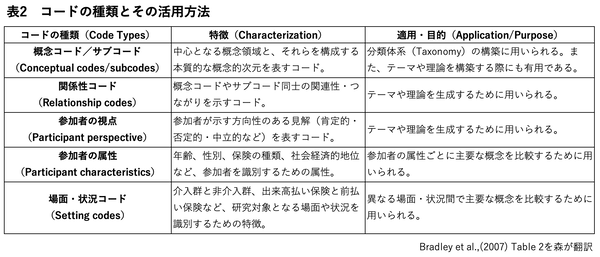
・統合的アプローチでは、コードを帰納的(ボトムアップ)に作成する方法と、コードの種類(スタートリスト)を整理するための演繹的な枠組みの両方を用いる
・5種類のコード(Table 2)は、分類体系(taxonomy)、テーマ(themes)、理論(theory)の生成に有用
コード構造の完成と適用(Finalizing and Applying the Code Structure)
・コードおよびコード構造は、理論的飽和(theoretical saturation)に達した時点で完成とみなせる
・分析過程で概念的な空白(conceptual gap)が見いだされた場合、新たに現れた概念やコードを明確化し、洗練するために、サンプルを拡大してデータ収集を継続すべき
・コードを用いてデータ収集を導く方法は理論的サンプリング(theoretical sampling)と呼ばれ、質的研究を実施する上で中心的な考え方
完成したコード構造の適用(Applying the Finalized Code Structure)
・完成したコード構造をデータへ適用する一つの方法は、研究チームの2~3名のメンバーがすべてのデータを再検討し、それぞれ独立して完成したコード構造に基づくコードを適用すること
・その後、研究チームは会議を開き、不一致があった箇所を確認し、十分な議論と合意形成を通して相違を解消する
・その結果、全データに対して最終コードを統一的に適用した一つの合意済みのコード化結果が得られる
・完成したコード構造を適用する別の方法としては、研究チーム内の複数のコーダーについて、選択した一部のデータを用いて信頼性を確立する方法
・コーダー間の信頼性確認後、そのうちの一人のコーダーが残りのデータを独立してコード化する
・コーダー間信頼性(intercoder reliability)は、新たなデータ(理論的飽和以前のコード開発段階では分析対象としなかった2~3件の逐語録等)を選び、2名の研究者が完成したコード構造を用いてそれらをコード化することで評価できる
・2名の研究者が逐語録を独立してコード化し、そのコード化結果の一致度を比較する
・すべてのコード化されたセグメントのうち、同じコードが付与された割合を算出する方法が一般的
・Miles and Huberman (1994)は、80%一致を、十分な信頼性を判断するための経験的な基準と提案
結果の生成(Generating Results)
概要(Overview)
・質的研究から得られる成果として、分類体系(taxonomy)、テーマ(themes)、理論(theory)の3種類に焦点を当てる
・これらの成果は、多面的な介入の測定方法の改善、サービスの質・コスト・アクセスの間に存在する因果関係についての仮説生成、さらに出来事の文脈が健康関連のさまざまな成果へどのような影響を及ぼすかについての洞察を得ることなど、多くの場面で有用である。
分類体系(Taxonomy)
・多面的で複雑な現象を、共通する概念領域とその次元に基づいて分類する体系
・質的研究法は、量的研究で一般的な二分法的分類(「介入群」と「対照群」)ではなく、洗練された方補うで複雑性を明確に記述する
・複雑な介入を本質的な構成要素へ整理する共通言語として、異なる介入を比較し、明確なコミュニケーションを促進するために極めて重要
・タクソノミーの例
・医療保険組織の分類体系(Welchら, 1990)
・統合医療システム(Gilliesら, 1993; Bazzoliら, 1999)
・認知症高齢者の目標設定(Bogardusら, 1998)
・病院における医療の質改善活動(Bradleyら, 2001)など
・タクソノミーの構造は概念コードおよびサブコードの構造をほぼそのまま反映
・概念コード:現象を特徴づける主要な領域(domain)を定義
・概念サブコード:各領域に含まれる共通の次元(dimension)を定義
・下位次元(subdimension)が存在する場合もある
・広い概念領域とその次元を特定するものであるという点で重要
・例:医療の質改善を分類したBradleyら(2001)の研究では、「組織目標」「管理的支援」「臨床リーダーシップ」「業務改善活動」「データ活用」「文脈要因」 という6つの領域を設定
・「組織目標」という領域の中には、「内容」「具体性」「挑戦性」「共有性」という4つの次元を含む
・各領域や次元では、コードは個々の発言そのものではなく、その背後にある抽象的概念を表す
・タクソノミーは、多面的な現象を特徴づける独立した概念軸を記述することを目的としている
テーマ(Themes)
・参加者の多様な経験から導かれる一般的命題であり、研究対象に繰り返し現れる統一的な考え方を示す
・概念コードやサブコードだけでなく、関係コードからも生成される
・例:医療サービス統合に関する研究(Gilliesら, 1993)では、「機能的統合」「医師間統合」「臨床統合 」という3つの概念がタクソノミーとして整理。その研究ではさらに、「完全な臨床統合は、機能的統合と、理想的には医師間統合が成功して初めて実現される」という命題が導かれた(←テーマ)
・テーマとは、概念領域を特定するだけではなく、それらの概念の関係性について述べる命題
・テーマを発展させる別の方法は、異なる参加者集団や異なるセッティング間で概念を比較分析すること
・研究者は、概念コードや関係コードだけでなく、参加者属性コードも用いてデータを抽出
・例:「出来高払い方式のメディケア利用者」と「従来型メディケア利用者」を比較し、特定の概念や概念間の関係、あるいは肯定的・否定的な見方が集団間で異なるかどうかを検討できる
・このような比較は、研究者が発言や観察を読み比べることで非公式に行われることもある
・Truth Table(Ragin, 1987, 1999)やExplanation Effects Matrix(Miles & Huberman, 1994)のような分析手法を用いて、比較群間における概念の出現状況を体系的に整理することもある
理論(Theory)
・相関関係や因果関係の本質に焦点を当て、出来事や経験、現象が生じる体系的な理由を明らかにする
・理論は現象を予測し、説明するもの
・理論を構築し報告するためには、関係コードによって整理されたデータが不可欠
・包括的な理論は、概念コード・サブコードだけでなく、関係コードや視点コードも統合する
・集団間比較も理論構築に利用されることがある
・理論構築は、概念間の関係を体系的に整理し、継続的比較法を用いて帰納的に概念コード・サブコード・関係コードを生成することで、より理解しやすいものとなる
・理論構築の方法は、研究対象、文脈、研究者自身の経験によって多様
結論(Conclusion)
・分類体系は、多面的介入を複数の領域・次元によって整理することで、現実世界の現象の記述・測定・評価を改善する
・テーマと理論は、多様な文脈における結果を説明し予測するための指針となる
・本論文では、帰納的推論と継続的比較法(Glaser & Strauss, 1967)の原理を用いながら、同時にあらかじめ定められたコードタイプ(概念コード、関係コード、視点コード、参加者属性コード、セッティングコード)を活用する、統合的な質的データ分析法を提示した。
ここまで。
個人的に大きな学びは2点ありました。
まず、分析の手順とその種類が示されたことで、全体像の解像度がグッと上がった気がします。
・コード化(概念、関係性、視点、属性、場面・状況)
↓
・分析結果(分類体系、テーマ、理論)
これまでは、何をコード化すべきなのかということについて、フリーハンドで考えていたのですが、5つの視点を提供してくれたことで考える際の補助線ができたように思います。
また、分析結果のまとめ方としても「分類体系(タキソノミー)、テーマ、理論」という3種の分け方があるというも新たな気づきでした。
・コード化したものを整理するのが「タキソノミー」
・コード化した物の関係性まで見るのが「テーマ」
・複数のテーマや概念間の関係を統合し、説明、予測できるようにしたものが「理論」
このように考えると、今の自分がやろうしている研究がどこを目指しているのかがよく理解できました。
もう一つの大きな気づきは、質的研究における帰納法と演繹法についてです。
基本的に質的研究は帰納法的に行うものだと思っていましたが、本論文では以下のような整理がされていました。
・GTA(Glaserら):コードは全てデータから生み出すべき(帰納法)
・Miles & Huberman:最初からコード(スタートリスト)を持っていても良い(演繹法)
個人的には、既存研究の理論や枠組みも使いながら質的研究ができればと思っていたので、この気づきはかなり大きかったです。
さらに、本論文では、これまで別々に語られてきた上記の2つの立場を統合する新たなアプローチが示されています。「既存研究から初期コードを準備し(演繹法)、データを見ながら新しいコードを追加していく(帰納法)」というものです。ここの記述がもう少し詳細に書かれていたら良かったのですが、それでも大いに参考になりました。
質的研究法について、新しい視点をたくさん得ることができた良き論文でした。
論文はこちら(被引用数:4,916件 (2026年6月29日時点))
Bradley, E. H., Curry, L. A., & Devers, K. J. (2007). Qualitative data analysis for health services research: developing taxonomy, themes, and theory. Health services research, 42(4), 1758-1772.
医療サービス研究の発展に役立てることを目的に書かれたものですが、約5,000件も引用されていることからも分かるように、質的研究法について大変参考になる内容がコンパクトにまとめられている論文です。
以下、各章ごとにポイントをまとめます。
・背景:質的研究の設計や質的データの収集については数多くの方法論的論文や古典的文献が存在する一方で、質的研究におけるデータ分析については比較的注目されてこなかった
・本論文の目的:インタビュー、フォーカスグループ、フィールド観察、一次・二次の質的データ(例えば、日記、会議録、年次報告書)あるいはこれらを組み合わせたデータ収集によって得られた質的データを分析するための、実践的な方略を提示すること
なぜ質的研究なのか(Why Qualitative Research?)
・質的研究は、現象をその文脈の中で理解し、概念や行動の間の関連性を明らかにし、理論を生成・精緻化することに適している
・量的研究は、出来事の発生頻度を数え、変数間の統計的関連を明らかにし、標本が抽出された母集団へ結果を一般化することを目的
・質的研究と量的研究は歴史的には相互に排他的なものと考えられてきたが、このような厳格な区別は、近年では不適切→混合研究法(Mixed Methods)(Creswell, 2003)では、必要に応じて質的方法と量的方法の双方を、同時または逐次的に用いることがある
質的分析の種類(Types of Qualitative Analysis)
質的研究には、学問分野、理論的立場、方法論、そして導き出される知見の種類において極めて大きな多様性が存在する(Yardley, 2000)。
・質的研究の伝統
・文化民族誌(Agar, 1996; Quinn, 2005)
・制度民族誌(Campbell & Gregor, 2004)
・比較歴史分析(Skocpol, 2003)
・ケーススタディ(Yin, 1994)
・フォーカスグループ(Krueger & Casey, 2000)
・インタビュー(Glaser & Strauss, 1967; McCracken, 1988; Patton, 2002; Quinn, 2005)
・参加観察および非参加観察(Spradley, 1980)
・ハイブリッド型アプローチ(複数の研究手法を組み合わせた)
・多くの研究者は、質的研究には統一された単一の方法論が存在することも、すべきでもないと主張
・本論文では、特に分類体系、テーマ、理論の生成に適した分析方略に焦点を当てる(Table 1)。
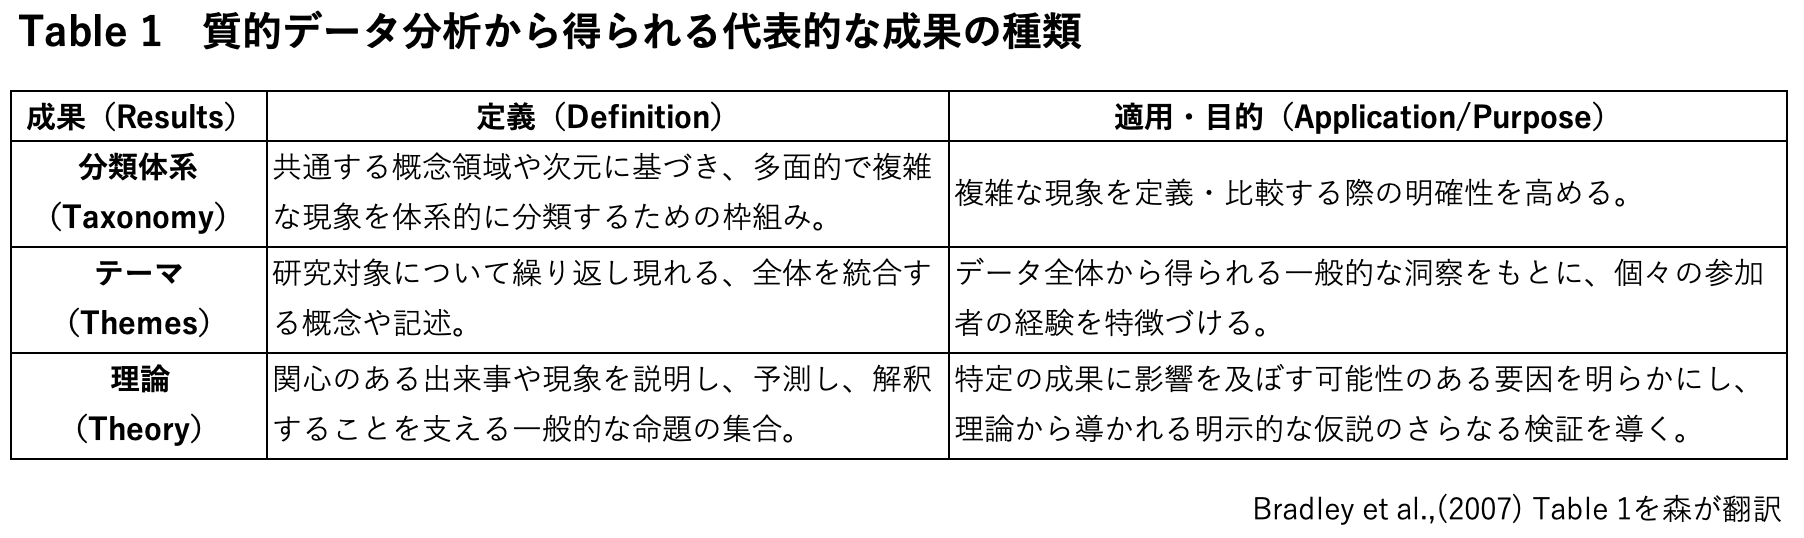
・分類体系(taxonomy)
・多面的で複雑な現象を、共通する概念領域や次元に基づいて体系的に分類する仕組み
・多様で複雑な介入を明確に定義し比較することを容易にする
・テーマ(themes)
・研究対象について繰り返し現れる統合的な概念や命題
・テーマは、データ全体から見えてくる一般的な洞察を通して、個々の参加者の具体的経験を特徴づける基本概念
・理論(theory)
・対象となる出来事や現象を説明し、予測し、解釈するための、一般化可能で修正可能な命題の体系
・潜在的因果関係や交絡要因を理解する上で重要で、現象が生じる文脈を理解するためにも重要
・その後の実証研究を導く枠組みとしても重要な役割を果たす。
分析の実施(Conducting the Analysis)
概要(Overview)
・質的データ分析を実施する唯一絶対に適切な方法は存在しない
・分析はデータ収集の初期段階から始まり、研究全体を通して継続する反復的なプロセスであるという点については、おおむね共通した理解がある
・以下の手順は、分類体系、テーマ、理論の生成を目標としながら、新たな概念を開かれた姿勢で発見していくことを可能にする体系的なアプローチ
全体像を把握するための読解(Reading for Overall Understanding)
・データ全体に深く入り込み、その意味を全体として理解することは、分析における重要な第一歩
・コーディングを行う前にデータ全体を読み込むことによって、概念間やその文脈とのつながりを失うことなく、新たなテーマを見いだすことができる
質的データのコーディング(Coding Qualitative Data)
・コードとは、Miles and Huberman(1994)が述べるようにタグ(tag)あるいはラベル(label)であり、文書全体または文書の一部分(例えば、段落、文章、単語)に付与されるもの
・コードは、概念が生じる文脈を保持したまま、主要な概念を整理・分類することを目的として付与される
・コーディングの過程には、コード体系(code structure)の作成、完成、そして適用が含まれる
・一部の研究者は、一人の研究者が全コーディングを担当するだけで十分であり、むしろ望ましいと主張
・特に、参加者との継続的な関係の中に研究者自身が深く入り込む研究に当てはまる
・この場合、自身が「研究の道具(instrument)」であり、データ収集と分析は密接に結びついている
・このような分析は、異なる研究伝統やパラダイムを持つ他者によって再現できない場合もあるため、研究者自身のバイアスや哲学的立場を明示することが重要
・一方、分析の幅と深さを高めるために、多様な背景を持つ研究者から成るチームでコーディングを行うことを推奨する研究者もいる
・このような研究チームでは、互いに訓練し合うこと(cross-training)が重要
コード体系の作成(Developing the Code Structure)
・コード体系をどのように構築するかについては、多様な考え方が存在する
・より帰納的であるべきか、それともより演繹的であるべきか
・どのような立場でも、十分に練られ、明確で包括的なコード体系は、その後の分析の質を高める
コード体系を構築するためのGTA(Grounded Theory Approach to Developing Code Structure)
・GTA研究者にとって、コード体系を構築する推奨される方法は、純粋に帰納的な方法
・研究者があらかじめ想定した結果を誤ってデータに「押し付けてしまう(forcing)」ことを防ぐことを目的(Glaser, 1992)
・データは一行ずつ詳細に検討され、ある概念が現れた時点でコードが付与される
・選択した概念を示す文章、段落、あるいはデータの一部分に下線を引き、コーディングしていく。
・データの検討が進むにつれて、コードの内容はデータに適合するよう発展・修正される。
・現在のデータ片を同じコードが付与されている他データ片と比較し、それらが同じ概念を表しているを判断する。
・この「継続的比較法(constant comparison)」を用いることで、既存コードの次元を精緻化するとともに、新たなコードを見出す
・この過程を通して、コード体系は帰納的に発展し、groundな参加者の経験を反映したものとなる。
コード体系を構築するためのより演繹的なアプローチ(More Deductive Approaches to Developing Code Structure)
・一部の質的研究者(Miles & Huberman, 1994)は、より演繹的なアプローチについて述べている
・まずコードを整理するための枠組み(organizing framework)から出発
・データを一行ずつ検討する前に、まず初期コードの構造を定義する
・あらかじめ設定されたコードは、既存研究で十分に知られている概念を研究者が統合する助けとなる
・例:医療サービス利用を研究する場合の演繹的アプローチでは、Andersen(1995)の行動モデルに基づき、「素因要因(predisposing factors)」「促進要因(enabling factors)」「必要要因(need factors)」といった事前に定められたコードから分析を開始することがある
・データを無理にそのカテゴリーへ当てはめてしまわないよう注意すべき
・このような「スタートリスト(start list)」(Miles & Huberman, 1994) を用いることによって、新たな研究は過去の知見を活用し、それを基盤として発展させることが可能となる
コード構造を開発するための統合的アプローチ(An Integrated Approach to Developing Code Structure)
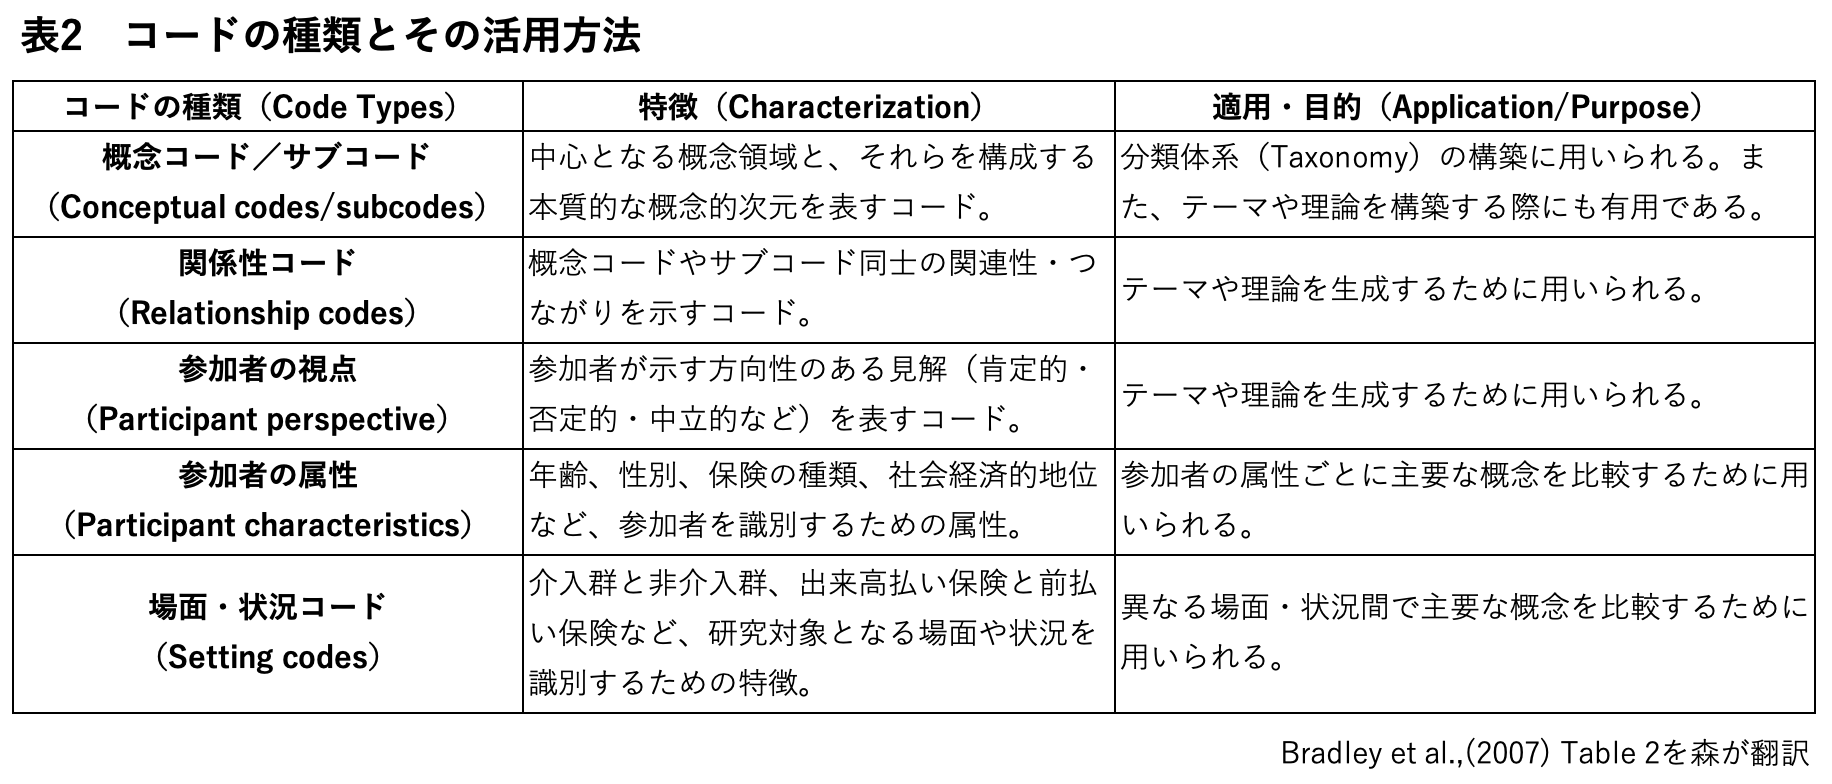
・統合的アプローチでは、コードを帰納的(ボトムアップ)に作成する方法と、コードの種類(スタートリスト)を整理するための演繹的な枠組みの両方を用いる
・5種類のコード(Table 2)は、分類体系(taxonomy)、テーマ(themes)、理論(theory)の生成に有用
コード構造の完成と適用(Finalizing and Applying the Code Structure)
・コードおよびコード構造は、理論的飽和(theoretical saturation)に達した時点で完成とみなせる
・分析過程で概念的な空白(conceptual gap)が見いだされた場合、新たに現れた概念やコードを明確化し、洗練するために、サンプルを拡大してデータ収集を継続すべき
・コードを用いてデータ収集を導く方法は理論的サンプリング(theoretical sampling)と呼ばれ、質的研究を実施する上で中心的な考え方
完成したコード構造の適用(Applying the Finalized Code Structure)
・完成したコード構造をデータへ適用する一つの方法は、研究チームの2~3名のメンバーがすべてのデータを再検討し、それぞれ独立して完成したコード構造に基づくコードを適用すること
・その後、研究チームは会議を開き、不一致があった箇所を確認し、十分な議論と合意形成を通して相違を解消する
・その結果、全データに対して最終コードを統一的に適用した一つの合意済みのコード化結果が得られる
・完成したコード構造を適用する別の方法としては、研究チーム内の複数のコーダーについて、選択した一部のデータを用いて信頼性を確立する方法
・コーダー間の信頼性確認後、そのうちの一人のコーダーが残りのデータを独立してコード化する
・コーダー間信頼性(intercoder reliability)は、新たなデータ(理論的飽和以前のコード開発段階では分析対象としなかった2~3件の逐語録等)を選び、2名の研究者が完成したコード構造を用いてそれらをコード化することで評価できる
・2名の研究者が逐語録を独立してコード化し、そのコード化結果の一致度を比較する
・すべてのコード化されたセグメントのうち、同じコードが付与された割合を算出する方法が一般的
・Miles and Huberman (1994)は、80%一致を、十分な信頼性を判断するための経験的な基準と提案
結果の生成(Generating Results)
概要(Overview)
・質的研究から得られる成果として、分類体系(taxonomy)、テーマ(themes)、理論(theory)の3種類に焦点を当てる
・これらの成果は、多面的な介入の測定方法の改善、サービスの質・コスト・アクセスの間に存在する因果関係についての仮説生成、さらに出来事の文脈が健康関連のさまざまな成果へどのような影響を及ぼすかについての洞察を得ることなど、多くの場面で有用である。
分類体系(Taxonomy)
・多面的で複雑な現象を、共通する概念領域とその次元に基づいて分類する体系
・質的研究法は、量的研究で一般的な二分法的分類(「介入群」と「対照群」)ではなく、洗練された方補うで複雑性を明確に記述する
・複雑な介入を本質的な構成要素へ整理する共通言語として、異なる介入を比較し、明確なコミュニケーションを促進するために極めて重要
・タクソノミーの例
・医療保険組織の分類体系(Welchら, 1990)
・統合医療システム(Gilliesら, 1993; Bazzoliら, 1999)
・認知症高齢者の目標設定(Bogardusら, 1998)
・病院における医療の質改善活動(Bradleyら, 2001)など
・タクソノミーの構造は概念コードおよびサブコードの構造をほぼそのまま反映
・概念コード:現象を特徴づける主要な領域(domain)を定義
・概念サブコード:各領域に含まれる共通の次元(dimension)を定義
・下位次元(subdimension)が存在する場合もある
・広い概念領域とその次元を特定するものであるという点で重要
・例:医療の質改善を分類したBradleyら(2001)の研究では、「組織目標」「管理的支援」「臨床リーダーシップ」「業務改善活動」「データ活用」「文脈要因」 という6つの領域を設定
・「組織目標」という領域の中には、「内容」「具体性」「挑戦性」「共有性」という4つの次元を含む
・各領域や次元では、コードは個々の発言そのものではなく、その背後にある抽象的概念を表す
・タクソノミーは、多面的な現象を特徴づける独立した概念軸を記述することを目的としている
テーマ(Themes)
・参加者の多様な経験から導かれる一般的命題であり、研究対象に繰り返し現れる統一的な考え方を示す
・概念コードやサブコードだけでなく、関係コードからも生成される
・例:医療サービス統合に関する研究(Gilliesら, 1993)では、「機能的統合」「医師間統合」「臨床統合 」という3つの概念がタクソノミーとして整理。その研究ではさらに、「完全な臨床統合は、機能的統合と、理想的には医師間統合が成功して初めて実現される」という命題が導かれた(←テーマ)
・テーマとは、概念領域を特定するだけではなく、それらの概念の関係性について述べる命題
・テーマを発展させる別の方法は、異なる参加者集団や異なるセッティング間で概念を比較分析すること
・研究者は、概念コードや関係コードだけでなく、参加者属性コードも用いてデータを抽出
・例:「出来高払い方式のメディケア利用者」と「従来型メディケア利用者」を比較し、特定の概念や概念間の関係、あるいは肯定的・否定的な見方が集団間で異なるかどうかを検討できる
・このような比較は、研究者が発言や観察を読み比べることで非公式に行われることもある
・Truth Table(Ragin, 1987, 1999)やExplanation Effects Matrix(Miles & Huberman, 1994)のような分析手法を用いて、比較群間における概念の出現状況を体系的に整理することもある
理論(Theory)
・相関関係や因果関係の本質に焦点を当て、出来事や経験、現象が生じる体系的な理由を明らかにする
・理論は現象を予測し、説明するもの
・理論を構築し報告するためには、関係コードによって整理されたデータが不可欠
・包括的な理論は、概念コード・サブコードだけでなく、関係コードや視点コードも統合する
・集団間比較も理論構築に利用されることがある
・理論構築は、概念間の関係を体系的に整理し、継続的比較法を用いて帰納的に概念コード・サブコード・関係コードを生成することで、より理解しやすいものとなる
・理論構築の方法は、研究対象、文脈、研究者自身の経験によって多様
結論(Conclusion)
・分類体系は、多面的介入を複数の領域・次元によって整理することで、現実世界の現象の記述・測定・評価を改善する
・テーマと理論は、多様な文脈における結果を説明し予測するための指針となる
・本論文では、帰納的推論と継続的比較法(Glaser & Strauss, 1967)の原理を用いながら、同時にあらかじめ定められたコードタイプ(概念コード、関係コード、視点コード、参加者属性コード、セッティングコード)を活用する、統合的な質的データ分析法を提示した。
ここまで。
個人的に大きな学びは2点ありました。
まず、分析の手順とその種類が示されたことで、全体像の解像度がグッと上がった気がします。
・コード化(概念、関係性、視点、属性、場面・状況)
↓
・分析結果(分類体系、テーマ、理論)
これまでは、何をコード化すべきなのかということについて、フリーハンドで考えていたのですが、5つの視点を提供してくれたことで考える際の補助線ができたように思います。
また、分析結果のまとめ方としても「分類体系(タキソノミー)、テーマ、理論」という3種の分け方があるというも新たな気づきでした。
・コード化したものを整理するのが「タキソノミー」
・コード化した物の関係性まで見るのが「テーマ」
・複数のテーマや概念間の関係を統合し、説明、予測できるようにしたものが「理論」
このように考えると、今の自分がやろうしている研究がどこを目指しているのかがよく理解できました。
もう一つの大きな気づきは、質的研究における帰納法と演繹法についてです。
基本的に質的研究は帰納法的に行うものだと思っていましたが、本論文では以下のような整理がされていました。
・GTA(Glaserら):コードは全てデータから生み出すべき(帰納法)
・Miles & Huberman:最初からコード(スタートリスト)を持っていても良い(演繹法)
個人的には、既存研究の理論や枠組みも使いながら質的研究ができればと思っていたので、この気づきはかなり大きかったです。
さらに、本論文では、これまで別々に語られてきた上記の2つの立場を統合する新たなアプローチが示されています。「既存研究から初期コードを準備し(演繹法)、データを見ながら新しいコードを追加していく(帰納法)」というものです。ここの記述がもう少し詳細に書かれていたら良かったのですが、それでも大いに参考になりました。
質的研究法について、新しい視点をたくさん得ることができた良き論文でした。
これより先はプライベートモードに設定されています。閲覧するには許可ユーザーでログインが必要です。

コメント